Cerebras afirma 5× de throughput de inferencia con desagregación
- Noticias
- Rocks on Galaxy
- Tech
- 04 Oct, 2026
- 1
Más tokens Cerebras sin comprar más wafers. El 1 de octubre de 2026, Unite.AI resumió el blog Cerebras Disaggregated Inference From The Ground Up: pruebas tempranas de desagregación heterogénea subieron el throughput de inferencia 5× con el mismo número de sistemas Cerebras y sin pérdida de velocidad de generación.
Prefill vs decode
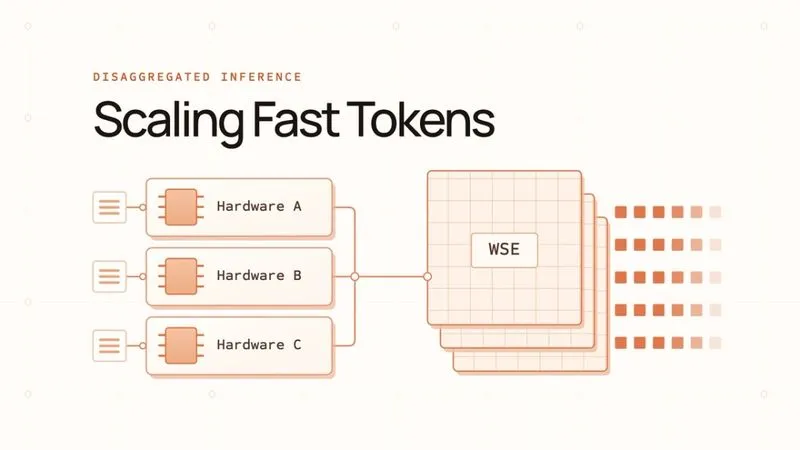
El prefill procesa el prompt completo en paralelo (cómpito intensivo). El decode emite tokens uno a uno con la caché KV (limitado por memoria). Separar fases en pools distintos permite dimensionar y priorizar cada una—a costa de transferir la caché KV.
Giro heterogéneo
- Decode en sistemas WSE Cerebras
- Prefill en aceleradores partners (diagrama: AWS Trainium, AMD Helios Instinct…)
- Pico publicado (10 sep. 2026): SRAM on-chip WSE-3 a 21.000 TB/s por wafer
- Artificial Analysis 10 sep. 2026: Cerebras a 1.669 tokens/s de salida en GPT-oss-120B (high reasoning, 10k input)
En serving agregado, un prefill grande puede frenar el decode; el batching sube throughput global pero puede ralentizar a cada usuario. Cerebras contrapone su SRAM wafer-scale a GPUs vía HBM. Próximos posts: stacks y economía a escala.
Veredicto Rocks
Resultados tempranos del vendor, PR: el 5× es test interno, no bake-off independiente. Fuente: Unite.AI 1 oct.
FAQ
¿5× = tokens 5× más rápidos por usuario? Cerebras habla de capacidad de throughput con la misma huella WSE y velocidad de generación sin cambios.
¿21.000 TB/s medidos en serving? No—pico publicado de SRAM on-chip.